


月10万円の外注OCRが月500円になる——Jina-OCR-v1が中小企業の「紙地獄」を終わらせる構造的理由

Related Articles
結論から言う。紙の書類処理に月10万円払っている会社は、来月から500円にできるかもしれない
請求書、契約書、納品書。地方の中小企業ほど紙が多い。そして紙が多い会社ほど、その処理を外注に出している。月10万、多いところで月30万。年間にすれば120万〜360万円。これが「紙をデータにする」だけのコストだ。
そのコストが月500円になるとしたら?
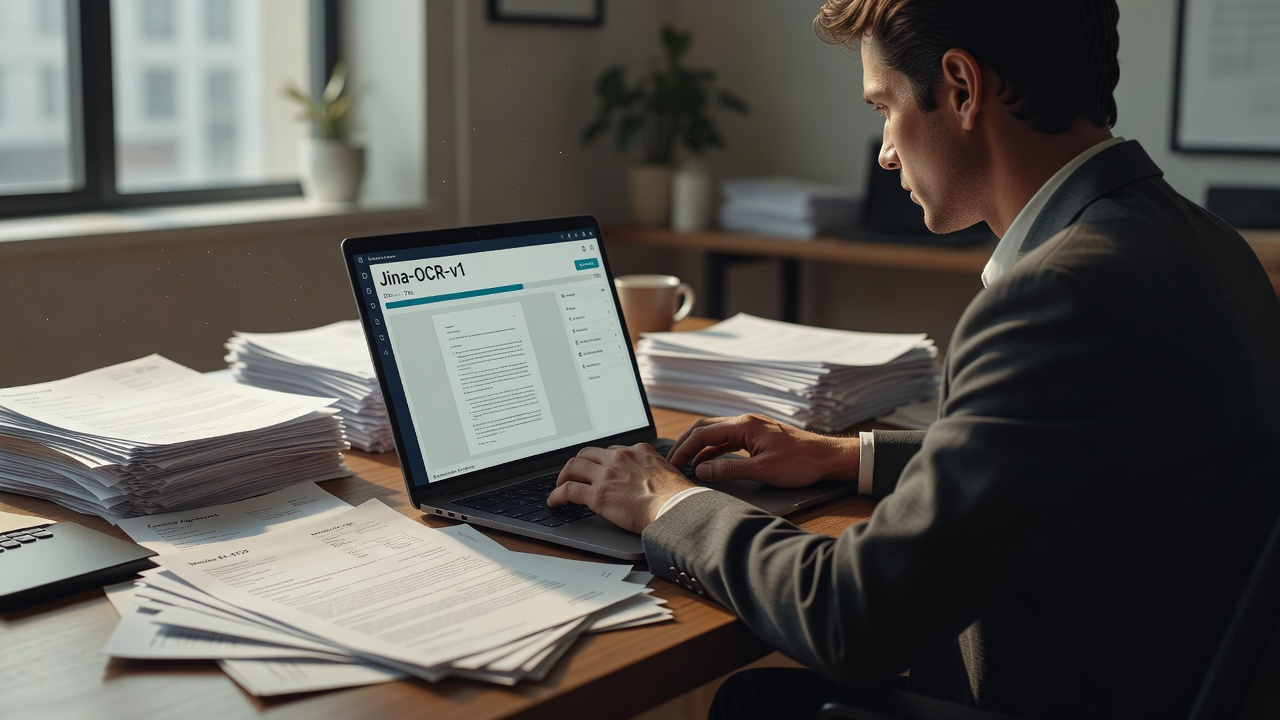
Jina AIが公開したOCRモデル「Jina-OCR-v1」は、まさにその可能性を現実にしつつある。低コストGPU1枚で動き、1秒あたり最大2.57ページを処理する。パラメータ数570M。軽い。速い。しかも精度が高い。
これは単なる技術ニュースではない。中小企業の事務コスト構造がひっくり返る話だ。
何がすごいのか——「安いGPUで実用精度が出る」という破壊力
従来、高精度なAI-OCRを自前で動かそうとすると、NVIDIA A100やH100といった高価なGPUが必要だった。1枚100万〜300万円。中小企業には論外の投資だ。
Jina-OCR-v1が動作するのは、NVIDIA L4クラスのGPU。クラウドで借りれば1時間あたり約0.5〜1ドル。月に数百ページ程度の処理なら、月額500円前後で収まる計算になる。
もう少し具体的に計算してみよう。
- 外注OCR(BPO型): 1ページあたり30〜100円。月3,000ページ処理で月9万〜30万円
- クラウドOCR API(Google Vision等): 1ページあたり1.5〜5円。月3,000ページで4,500〜15,000円
- Jina-OCR-v1(自前運用): L4インスタンスを月数時間起動。月3,000ページなら約20分で処理完了。クラウドGPU費用は数百円
200分の1。この差は誤差ではない。構造的な変化だ。
精度は本当に使えるのか?——ベンチマークの数字を見る
コストが安くても精度が低ければ意味がない。ここが最も重要なポイントだ。
Jina-OCR-v1の公開ベンチマーク結果はこうなっている。
- OmniDocBench v1.6: 91.14(文書構造認識の総合スコア)
- olmOCR-Bench: 83.4
これがどの程度かというと、GPT-4oやClaude 3.5といった大規模モデルのOCR性能と比較しても遜色ないレベルだ。しかもJina-OCR-v1は570Mパラメータ。GPT-4oの数百分の1の規模で、ほぼ同等の精度を出している。
さらに注目すべきは、「複雑なレイアウトへの対応力」だ。請求書のように表組みが多い書類、契約書のように段組みや注釈がある書類。従来のOCRはこうした「構造が複雑な文書」で精度が落ちた。Jina-OCR-v1は動的解像度設定を採用しており、文書のレイアウトに応じて処理を最適化する。つまり、定型フォーマットだけでなく、取引先ごとにバラバラな請求書フォーマットにも対応できる。
中小企業の現場では「取引先100社、請求書のフォーマット100種類」が当たり前だ。ここに対応できるかどうかが、実用性の分かれ目になる。
「月500円」の内訳——本当にそれで済むのか
正直に書く。「月500円」はあくまで最小構成での試算だ。実際の導入にはいくつかの追加コストがある。
最小構成(月3,000ページ以下の場合)
- クラウドGPU(L4相当): 月500〜2,000円(従量課金で必要な時だけ起動)
- ストレージ・通信費: 月数百円
- 合計: 月1,000〜3,000円
現実的な構成(月1万ページ、エラーチェック込み)
- クラウドGPU: 月3,000〜5,000円
- エラー修正の人的コスト: 月1〜2時間(既存スタッフで対応)
- 合計: 月5,000〜8,000円
外注の月10万円と比べれば、現実的な構成でも10分の1以下。年間で100万円近い削減になる。5人規模の会社にとって、これは無視できない金額だ。
導入は本当に簡単か?——現場目線のステップ
ここが一番大事な話だ。技術的にすごくても、現場で使えなければ意味がない。
ステップ1: まず10枚で試す(所要時間30分)
Jina-OCR-v1はHugging Faceで公開されている。Google ColabでL4 GPUを選択すれば、無料枠でも試せる。自社の請求書や契約書を10枚スキャンして、読み取り精度を確認する。ここで「使える」と判断できれば次に進む。
ステップ2: 業務フローに組み込む(1〜2週間)
スキャンした書類をフォルダに入れると自動でOCR処理が走り、CSVやJSONで出力される仕組みを作る。Pythonスクリプト数十行で実現できる。社内にエンジニアがいなくても、ChatGPTにコードを書かせれば動くレベルだ。
ステップ3: エラーチェックの仕組みを入れる(1週間)
OCRの精度が91%ということは、100項目中9項目は間違う可能性がある。金額や日付など重要な項目だけ人間が目視確認するフローを入れる。ここを飛ばすと事故になる。OCR-EDRのようなエラー診断フレームワークを併用すれば、「どこが怪しいか」を自動でハイライトしてくれるので、チェック時間も短縮できる。
ステップ4: 運用して改善する(継続)
1ヶ月回してみて、エラーが多いパターンを特定する。特定の取引先の請求書だけ精度が低い、といったケースが出てくる。そこだけ手動対応に切り替えるか、前処理(スキャン品質の改善等)で対応する。
重要なのは「いきなり全業務を切り替えない」ことだ。まず1業務、10枚から。これが鉄則。
本当に考えるべきこと——「OCRが安くなった先」に何が起きるか
月10万円が月1,000円になる。この変化の本質は「コスト削減」ではない。
「紙の書類をデータにすること」のコストがほぼゼロになると、何が起きるか?
これまでコストが高すぎてデータ化を諦めていた書類が、全部データになる。過去10年分の契約書。倉庫に眠っている発注履歴。取引先との手書きのFAX。
データになれば、検索できる。分析できる。AIに食わせて傾向を読める。
「あの取引先との契約条件、3年前はどうだったっけ?」——これまで30分かけてファイルキャビネットを漁っていた作業が、3秒の検索で終わる。
「この仕入先、過去5年で単価がどう推移している?」——OCR+表計算で即座にグラフ化できる。
つまり、OCRのコスト崩壊は「データ化」のコスト崩壊であり、その先にあるのは「中小企業がデータで意思決定できるようになる」という構造変化だ。
大企業はとっくにやっている。ERPに何千万円も投資して。中小企業は紙のまま、経験と勘で回してきた。その差がOCR1つで縮まる。これが本当の意味での逆転の構造だ。
で、結局どうすればいいのか
- 今週中に: Google ColabでJina-OCR-v1を動かしてみる。自社の請求書10枚で試す。無料でできる
- 精度に納得したら: 月1,000〜5,000円の予算でクラウドGPUを契約し、自動処理の仕組みを作る
- 外注OCRの契約更新前に: コスト比較の数字を出して、経営判断する
技術の進化を待つ必要はない。Jina-OCR-v1は今日、すでに使える。月10万円の外注費を払い続けるか、今週30分使って試してみるか。答えは明らかだろう。
—

 JA
 EN